sobota, 17 stycznia 2015

Duża macierz podobieństwa i wizualizacja gatunków muzycznych w Polsce.

Problem

Poprzednio skorzystaliśmy z dwóch systemów bazo-danowych do przechowywania danych pobranych "na żywca" (Web Scraping) oraz przez WebApi  Przechowywanie dużych zbiorów danych na dysku pozbawia Nas problemu przeładowania pamięci podręcznej, przez co możemy sobie swobodnie wybierać podpróby, tworzyć agregaty, modyfikować dane itd.. Problemem pozostaje jednak poruszanie się w nowym środowisku zastępując część operacji, które wykonalibyśmy w R, zapytaniami w języku SQL i MongoDB (JSON). Ponieważ ani SQL ani MongoDB nie są tak rozbudowane jeżeli chodzi o manipulacją danymi, zaprezentuję R jako dobrego pomocnikia w tworzeniu zapytań. R może znacznie ułatwić workflow z zewnętrznymi bazami danych, uruchamiając całe zestawy wygenerowanych zapytań zamiast pisania kwerend jedna po drugiej.
Drugim problemem jest dalsze postępowanie z wyselekcjonowanymi danymi, które pomimo tego, że są tylko skrawkiem całej bazy nadal pozostają nadal dużym kłopotem. W pierwszej kolejności na przeszkodzie stoi przekształcanie do zbioru finalnego, co z wykorzystaniem popularnych pakietów takich jak np. dplyr czy tidyr jest nie możliwe. Często rozwiązaniem w takich przypadkach jest zejście poziom niżej i inwencja samego programisty. Na szczęście nie jest aż tak źle, bowiem społeczność R-owa dostarcza pakiety, które trochę ułatwiają pracę, cobyśmy nie musieli grzebać w C++ (przynajmniej dzisiaj nie musimy). Dzisiejszym problemem jest analiza podobieństwa pomiędzy wszystkimi tagami z last.fm przypisanymi do wszystkich wykonawców notowanych na liście Olis w całym okresie trwania. Nie komplikując sprawy czyszczeniem, liczebność zbioru tagów to 20573. Oznacza to, że taka macierz podobieństwa miałaby 423mln elementów, jak to zrobić w R? Jak potem wyciągnąć wnioski z takiej macierzy?

poniedziałek, 5 stycznia 2015

Alternatywne sposoby przechowywania dużych zbiorów danych - SQLite i MongoDB

Problem
 
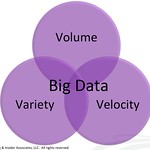
Big Data Dzisiejszy temat pod bardzo popularnym hasłem kluczowym - Big Data. Big Data czyli dane których wolumen, prędkość napływania lub zróżnicowanie przekracza możliwości tradycyjnych metod analizy. Czym jest Big Data dla przeciętnego PC, a czym dla klastrów Amazona. Tajemniczy termin jest często używany przesadnie tłumacząc nieumiejętne zarządzanie danymi (też tak mówiłem). Prawdą jest jest, że przeciętny PC z asystą typowych narzędzi jest w stanie przerobić kupę danych. Nie sposób wyczerpać tak rozległego tematu jednym wpisem. Big Data stanowi problem na każdym etapie procesu analizy danych. Dzisiaj skupię się na przechowywaniu danych, a temat obliczeń poruszę przy nadarzającej się okazji.
R przechowuje dane w RAM'ie co sprawia, że operacje są wykonywane szybciej niż gdyby dane przechowywane były na dysku twardym. Przechowywanie danych w pamięci podręcznej jest jednak mocno ograniczona rozmiarem. Niejednokrotnie zdarzało się, że ładowanie danych do R kończyło się fiaskiem, zwieńczając męki komunikatem "out of memory ...". W zależności od problemu przed jakim stoimy proponuje się różne rozwiązania.

czwartek, 25 grudnia 2014

Pozyskiwanie danych (cz. 3) - wprowadzenie do API na przykładzie last.fm

Problem
last.fm at fowa.Po zdobyciu wszystkich notowań listy Olis, mamy tyle przydatnych danych co kot napłakał. Dysponujemy niewielką liczbą informacji na temat wykonawców, być może wystarczającą żeby wygenerować proste statystyki ale to wciąż za mało żeby cokolwiek wnioskować o charakterystyce notowań. Oczywiście niektórzy czytelnicy mogą wiedzieć sporo o rynku muzycznym i w łatwy sposób określić np. gatunek muzyczny danego artysty, skalę popularności itd. Problem w tym, że w chwili obecnej w bazie danych mamy ich >1500, a ta liczba będzie przyrastać z każdym tygodniem. Drugim problemem jest to, że nawet największy znawca rynku muzycznego może mieć problem z określeniem np. skali popularności.
Tym wpisem potwierdzę jak ważne wg. Mnie jest sprawne obracanie się w świecie dostępnych danych, powtarzając do znudzenia problem naświetlany w moim pierwszym wpisie. Nie jestem bynajmniej odosobniony w tej kwestii. Ostatnio także smarterpoland pisał jak uczyć i jak uczyć się analizy danych, wskazując na dużą wagę umiejętności "inżynierskich", związanych z pozyskiwaniem danych, w tym również za pośrednictwem webAPI. Czym właściwie jest webAPI?

czwartek, 18 grudnia 2014

Owoce skryptowania, czyli 0% czasu analityka - cd. Baza danych Olis (cz. 2)

Problem

IC0351460 Pobieranie danych z sieci często nie kończy się po kilku godzinach pracy skryptu. Z reguły bazy potrzebują aktualizacji, ciągłej, regularnej lub doraźnej. Podobnie jest w przypadku notowań Olis. Kolejne wyniki rankingu sprzedaży pojawią się w piątek, w następny piątek kolejne itd. W przypadku gdybyśmy prowadzili systematyczne, częste analizy, nie moglibyśmy pozwolić sobie na cotygodniowe ściąganie danych w całości. Zamiast tego program co jakiś czas odwiedzi jeden/dwa/trzy linki i po sprawie. Jednocześnie chcielibyśmy żeby odbyło się to bez Naszej inicjatywy i aby cały proces działał w tle, bez uruchamiania zasobochłonnego okna przeglądarki, z minimalną kontrolą procesu.
Wyobraźmy sobie teraz sytuację, w której mamy kilkanaście skryptów, które systematycznie muszą wykonywać jakąś robotę. Jak już automatyzować, to do końca, tak abyśmy mogli zajmować się bieżącą pracą, bez konieczności angażowania godziny w tygodniu na uruchamianie crawlerów. Oh, jakże ciężko jest wyrwać się z wiru zadań i deadline'ów tylko po to żeby zrobić update. Zwykle usprawiedliwiamy się, zrobię to jutro, za tydzień zaciągnę z zaległymi itd. W końcu po dwóch miesiącach, uruchamiamy skrypt bo musimy, a tu niespodzianka - zmiany w kodzie źródłowym! $%^@$%&^*

niedziela, 14 grudnia 2014

One R to rule them all

Problem

Dzisiejszy post jest konieczny do przejścia do następnych części ciągu wpisów na temat web-scrapingu. W kolejnych artykułach pojawią się treści, w których wykorzystywać będziemy poniższe rozwiązanie. Jako, że dzisiejsza treść jest związana nie tylko z web-scrapingiem, dlatego może być traktowana jako osobny byt.
Nie jest żadną tajemnicą, że R nie jest samowystarczalny. Większość mistrzów danych wykorzystuje rozmaite biblioteki napisane w takich językach jak Java, C, a R używa jako narzędzie, które wiąże koniec z końcem.

Nie oznacza to jednak, że ktoś korzystający z "obcej" biblioteki musi umieć programować w języku jej pochodzenia. Czytelnicy, którzy przebrnęli przez 1 cz. serii o web-scrapingu świadomie bądź nieświadomie skorzystali za pomocą R z zewnętrznej biblioteki Selenium. RSelenium pełni rolę nakładki, która steruje pracą Selenium 2.0. Gdyby jednak pakiet RSelenium nie istniał, nie oznaczałoby jeszcze, że nie byłaby możliwa komunikacja z Selenium 2.0 - Moglibyśmy, z tą różnicą, że byłoby to bardziej pracochłonne. Wiele pakietów dostępnych w R zostało napisanych jako swoiste API do zewnętrznych bibliotek, co jest sytuacją często spotykaną nie tylko w Naszym środowisku. R może również komunikować się z systemem operacyjnym za pomocą poleceń system(), shell() umożliwiając wykonanie poleceń tj. zamknięcie systemu, odpalenie dowolnej aplikacji, kopiowanie plików itd.

wtorek, 9 grudnia 2014

Pozyskiwanie i organizacja danych - 101% czasu pracy analityka. Baza danych Olis (cz. 1)

Wstęp 

Jako, że jest to pierwszy wpis publiczny w tej części przestrzeni wirtualnej, chciałbym przywitać wszystkich, którzy w niewyjaśnionych okolicznościach znaleźli się na moim blogu. Zgodnie z opisem, blog jest wynikiem mojej przynależności do społeczności eRowej, której chciałbym coś dodać od siebie. Blog w zamyśle ma pełnić z jednej strony funkcję surowego nauczyciela, a z drugiej zaskakiwać ciekawymi rozwiązaniami tych bardziej doświadczonych. Dodawane treści pomimo swojego programistycznego charakteru, dotykać będą sfery danych statystycznych od pozyskiwania (dzisiaj), przez organizację, analizę do wizualizacji. 
Zdaję sobie sprawę, że dzisiejszy wpis może być dla niektórych "magią" - nie przejmujcie się, umyślnie podkręciłem śrubę. Sporo operacji wykonywanych dzisiaj będą powtarzane do znudzenia w przyszłości. To czego dzisiaj nie wiemy, jutro będziemy przekazywać innym. Powodzenia! 


Problem 

Współczesny analityk danych to coś więcej niż naukowiec zgłębiający tajemnice metod numerycznych. Współczesny analityk to inżynier zarządzający całym procesem analitycznym od pozyskiwania danych, poprzez organizację, stosowanie metod statystycznych do wniosków z danych płynących. Z połączenia cech menadżera, informatyka i statystyka powstaje nie Kapitan Planeta ale Mistrz danych, profesja pierwszoligowa potrzebna praktycznie wszędzie. Umiejętności programistyczne wykorzystuje się na każdym etapie pracy z danymi i pozwala zaoszczędzić setki godzin spędzonych na czyszczeniu, wklepywaniu danych, szukaniu modeli. Programowanie w procesie analitycznym ma jedną bardzo, ale to bardzo ważną zaletę - jest dokumentem, zapisem Naszych prac. Gdy coś nie gra, łatwo możemy wrócić do etapu, w którym popełniliśmy błąd i praktycznie bez straty czasu wykonać poprawiony proces.